翻訳横丁の裏路地

We can do anything we want to do if we stick to it long enough.


2件のコメント

生成AIで「もうひとりの翻訳チェッカー」を育てる

個人翻訳者が自分の翻訳をチェックするとき、避けて通れない問題があります。
それは、チェックする目がひとりしかないということです。

翻訳を終えたあと、何度も読み直して誤りを探す。時間を置いてチェックしたり、チェックする場所を変えたり、いろいろ工夫している方も多いでしょう。しかし、自分が翻訳した文章には、どうしても思い込みが入り込みます。正しく翻訳したつもりになっているため、誤りがあっても気づかずに読み飛ばしてしまう。ケアレスミスの厄介なところです。品質保証の観点からいえば、こうしたミスの流出を防ぐ簡単で有効な対策のひとつがダブルチェックです。自分とは別の人間がチェックするダブルチェックのことで、本人が見落とした誤りを検出できる可能性が高くなります。

ところが、個人翻訳者の場合、別のチェック担当者は基本的にいません。外部委託するという方法もありますが、契約上の制限や、コスト的問題で必ずしも確保できるわけではありません。
そこで、生成AIをもうひとりのチェック担当者として使おうという発想です。

もちろん、生成AIは人間のチェッカーと同じではありません。間違った指摘をすることもあれば、誤りを見落とすこともあります。それでも、自分とは異なる方法で文章をチェックする目が加われば、ひとりでチェックする場合よりも、誤りを検出する機会を増やせるはずです。つまり、生成AIを使って疑似ダブルチェックを可能にするのです。

多くの方が誤解されていると思うのですが、生成AIに「この翻訳をチェックしてください」と指示するだけでは、期待するチェック結果は得られません。人間の翻訳者やチェッカーに指示を与えるときと同様に、自分の翻訳に対する考え方や判断基準を指示として与えることで、自分の翻訳を理解したチェック担当者に生成AIを育てていきます。
今回は、そのための方法をご紹介します。

続きを読む →


【翻訳の日】この10年を振り返る

9月30日は「翻訳の日」です。
日常ではあまり深く考える機会がない「翻訳」について、この機会に、少し長い時間軸で翻訳という仕事を振り返ってみたいと思います。

10年前の2016年と、2026年の現在。わずか10年ですが、翻訳を取り巻く環境は大きく変わったと感じています。
翻訳界隈では、最近、生成AIに関する情報を頻繁に目にし耳にする機会が増えてきました。この流れは、実は、10年前から始まっていたことです。そこで、これまでの10年間を私の知る範囲で振り返ってみます。

ニューラル機械翻訳の登場

2016年当時、CATツールや翻訳メモリはすでに存在していました。2016年9月にGoogleが、Google Neural Machine Translationを発表し、11月にGoogle翻訳にNMTが導入され、それ以前の統計的MTの翻訳出力に比較して、飛躍的に質の高い出力がされるようになりました。翌2017年には、現在の生成AIにつながるTransformerが発表され、そして同年8月にDeepLが登場しました。

NMTの登場は、翻訳業界でも大きな話題になりました。(一社)日本翻訳連盟が発行している翻訳通訳白書(当時、翻訳白書)の2017年版には、「機械翻訳の普及という昨今のトレンドを考慮し、機械翻訳も調査対象に加えました」とあり、法人向け質問に「機械翻訳の活用状況」が初めて加わりました。この状況から見ても、NMTが翻訳業界に与えたインパクトの大きさがうかがえます。
「自社サービスですでに(機械翻訳を)活用している」が15.6%、「自社サービスで活用していないが(利用を)検討している」が35.5%という回答状況から、機械翻訳利用へシフトしつつある状況であったと想像できます。

生成AIの登場と業界への浸透

ChatGPTの登場は、2022年11月末です。最新(2024年版)の翻訳通訳白書によれば、「時々使用する」まで含めた機械翻訳の使用率は66.4%でした。なお、記載された情報では、機械翻訳と生成AIは明確に区別されておらず、すべて「機械翻訳」にまとめられているようですので、このデータからは生成AIの浸透度は判断できません。最新情報として参考になるかと2026年のEuropean Language Industry Surveyを参照しましたが、やはり「機械翻訳」と「生成AI」の区別は曖昧のようです。2024年版翻訳通訳白書の調査当時(2025年3~4月)は、企業がやっと生成AIを導入し始めていたタイミングだと思いますので、いま調査するとさらに高い数字になるだろうと想像します。

続きを読む →


どのローカルLLMが動くのか

以前、「完全オフライン環境で動作する生成AIモデルの日英翻訳能力比較レポート」という記事を書きましたが、情報漏洩リスクのあるクラウド系生成AIを避け、ローカルLLMの利用を考える企業や人が増えているようです。

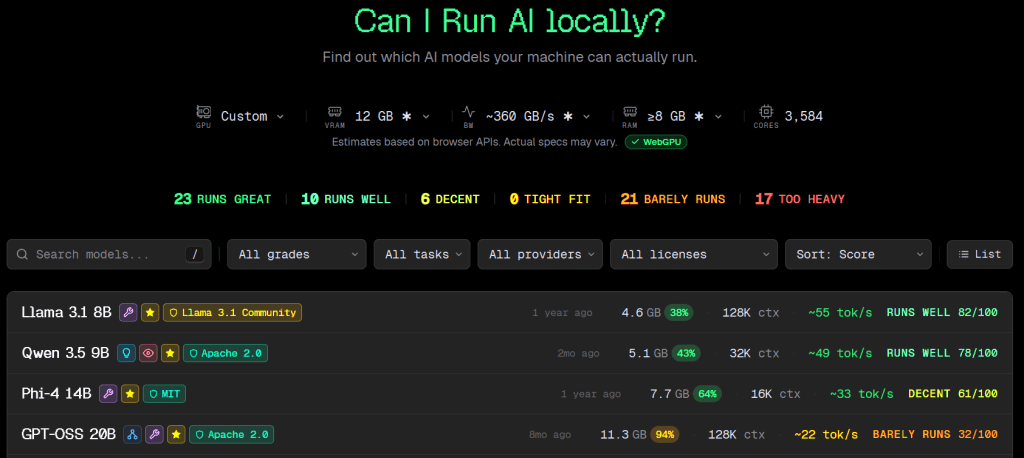
そこで問題になってくるのは、自分のPCにローカルLLMを導入する場合、どのモデルなら快適な速度で動くのかという点ですよね。それを教えてくれるサイトがありました。以下URLの「Can I Run AI Locally?」というサイトです。

https://www.canirun.ai/

ローカルLLMを導入する予定のPCでこのサイトにアクセスすると、使用しているPCのCPU, GPU, Memoryを検出して、さまざまなモデルを動かした場合の快適度を表示してくれます。
次のスクショは、私のPCをチェックした結果です。

右に表示される「RUNS WELL」や「DECENT」が動作の快適度ですが、私の体感と合っています。ライセンス種類も表示してくれるので、商用利用される場合は参考になるでしょう。

流石に私のPCのスペックが低いので、パラメータサイズ14B辺りまでが精一杯のようです。ちなみに私が持つMacbook Air (M1, 8GB)で確認したら、4B辺りで「DECENT」でした。

以上、ローカルLLMを選択する際の参考にしてみてください。


人間はいつまで翻訳を職業にできるのだろうか

私が翻訳会社(に類する企業)に勤め始めたのが、今から20年程前(え?もうそんなに昔?(笑))。

当時はまだNMTも生成AIもありませんでした。頓珍漢な出力をする機械翻訳(MT)は存在していましたが、ビジネス的に利用するメリットを感じず、手を出しませんでした。あの頃は、産業系翻訳の依頼がまだまだ潤沢にあった時代でした。

いまはどうでしょうか。2016年に Google が NMT を公開し、その後、2022年にOpenAiが生成AIであるChatGPTを公開して一般での利用が可能となりました。その後も生成AI技術はどんどんと進化していますが、これらAIの普及に伴って翻訳の依頼が減少したという話を良く耳にします。私もその影響を受けたひとりです。また、翻訳に携わる人々の仕事の内容が少しずつ変化してきているように思います。以前から翻訳をしていた方々の仕事内容も、翻訳からチェックやポストエディットに軸足が変化しているように見えます。

この半年を見ても生成AIの進歩には目を見張るものがあります。この先、我々翻訳者、あるいは翻訳関係者の仕事はどうなっていくのでしょうか。最近、翻訳者が集まると必ず出る話題のひとつですよね。程度に差はあれ「翻訳という仕事が徐々に奪われていく未来」を多くの人が感じているように思います。

では、私たちは今、どの辺りにいるのでしょうか。

続きを読む →


完全オフライン環境で動作する生成AIモデルの日英翻訳能力比較レポート

生成AIを翻訳支援ツールとして利用する場合、障害となるのが情報の取り扱い。従来のクラウド型生成AIでは、入力した情報がクラウド上のシステム内で内部利用される可能性があるため、守秘義務のある情報や、情報漏洩を避けたい個人情報を含むデータを入力することができず、生成AIの活用に制限がありました。

7月8日に、LM Studioの企業・団体での利用が無償化されるというアナウンスが出ました。

LM Studio is free for use at work

記事のChatGPTによる和訳要約
LM Studioは、これまで家庭での個人利用のみ無料でしたが、2025年7月8日から企業・商用利用も完全無料になりました。これにより、会社やチームでも申請や手続き不要で自由に使えるようになります。データはローカル保存のままでプライバシーも保たれ、外部送信の心配はありません。今後は、無料のチーム共有機能や、有料のエンタープライズ向けプラン(SSOやアクセス制御など)も順次提供予定です。研究開発や業務効率化を進めたい企業にとって、大きなメリットとなる方針転換です。

これにより、情報セキュリティの問題で生成AIの導入が進まなかった企業でも、LM Studioなどを利用したローカル環境だけで動作する生成AIの利用が進むのではないかと思います。また、個人翻訳者の立場で考えても、同様の理由から、生成AIを翻訳支援に利用するハードルが低くなりました。

私は以前から、翻訳(特に英訳)の相談役として ChatGPT を使い続けていますが、それはこちら求める英語に関する質問に対して、期待する回答品質を持っているからです。さて、ローカル環境だけで動作する生成AIでは、果たして期待した回答品質が得られるのか、そこが大きな問題です。ローカル環境で動作可能なモデルサイズですので、翻訳においてクラウド系生成AIのような質は期待できないかもしれません。

そこで、自分の使用目的を前提に、DeepSeek-r1、Gemma-3-12b、Gemma-3-27bの3つのモデルで、日英翻訳を行って翻訳評価を行いました。その結果をレポートにまとめたもの(簡易版)が、以下のPDFファイルです。

もしご興味がありましたら、ご閲覧ください。